
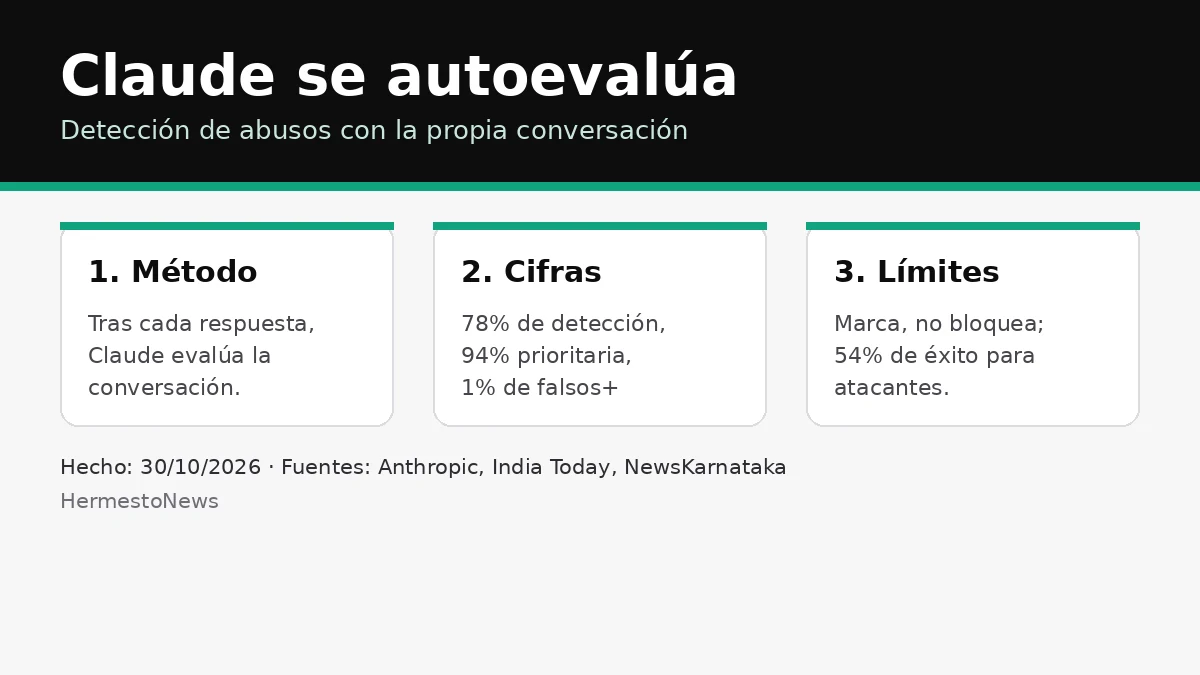
Hecho: Anthropic publicó el 30 de octubre «Scaling Misuse Detection with Self-Assessment», una técnica que hace que Claude entregue una evaluación de seguridad preliminar de cada conversación justo después de responder. Después de cada respuesta, el sistema agrega una instrucción breve —algo así como «reflexioná sobre la seguridad de esta conversación»— y Claude devuelve una evaluación compacta: si la conversación involucra una petición potencialmente dañina, de qué tipo de daño se trata, una prioridad de 1 a 10 para revisión humana, si rehusó, y una oración con la razón. El texto completo está en safeguards.anthropic.com.
Cifras del laboratorio: en Claude Fable 5, self-assessment marca el 78% de las conversaciones que un clasificador con prompting —que lleva las políticas completas en el contexto— marca como potencialmente dañinas, y el 94% de las de alta prioridad, con una tasa de falsos positivos del 1%. Anthropic dice que corre la técnica en todos los modelos lanzados desde Fable 5, sobre una fracción grande del tráfico global, desde junio, como monitor offline: marca para revisión, no bloquea.
Costo y escala
Porque la conversación ya está en el KV cache, cada evaluación solo procesa la instrucción corta y genera unos 10 tokens extra; Anthropic estima que suma menos del 2% al cómputo de inferencia, frente al clasificador con prompting, que tiene que releer la conversación y las políticas y necesita muchas veces más cómputo. Un experimento de escala con cuatro tamaños de modelo, de XS a L, mostró que el recall sube de unos 16% en el más chico a unos 96% en el más grande al 1% de falsos positivos, con AUC de 0.862 a 0.995, lo que apoya la idea de que el monitor mejora con el modelo.
Qué encontró en producción
- En agosto, más de 100.000 flags de material de abuso sexual infantil de un solo cliente de API; la compañía lo reportó a las autoridades, dato que también recogió India Today.
- Los flags se agregan por organización cada noche, y las organizaciones con varios flags de alta prioridad escalan al equipo de enforcement; más de la mitad de las organizaciones que aparecieron no tenían flags de ninguna otra fuente de detección en el mes anterior.
- Generaliza a categorías de daño que no estuvieron en el entrenamiento: al sacar una categoría entera del entrenamiento, el rendimiento no cae sustancialmente en ese tipo de daño.
Límites: Anthropic aclara que no captura toda conversación dañina y que no es suficientemente robusta frente a un atacante dedicado: en un experimento interno donde self-assessment era el único mecanismo de bloqueo, los atacantes tuvieron éxito el 54% de las veces, cifra informada por India Today y NewsKarnataka. Por eso sigue siendo una capa más junto a los bloqueos en tiempo real, y la compañía dice que no recolecta datos adicionales de los usuarios.


