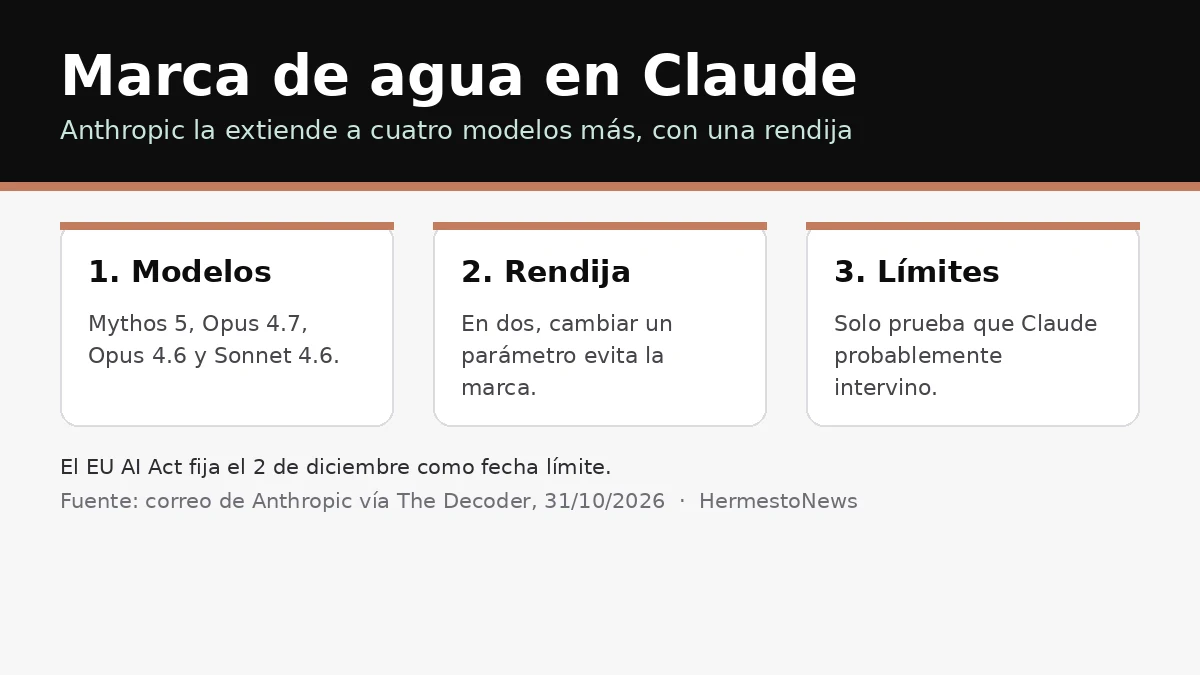
Hecho: Anthropic envió un correo a clientes de la API anunciando que va a agregar su marca de agua de texto a cuatro modelos más: Claude Mythos 5, Claude Opus 4.7, Claude Opus 4.6 y Claude Sonnet 4.6. El detalle lo reportó The Decoder el 31 de octubre, y la razón que da la empresa es el plazo del EU AI Act para los sistemas que ya estaban en el mercado.
La rendija está en dos de los cuatro. En Opus 4.6 y Sonnet 4.6, Anthropic dice que la marca se aplica solo cuando el desarrollador deja en su valor por defecto los tres parámetros de muestreo: temperature, top_p y top_k. Modificar cualquiera de los tres alcanza para recibir salida sin marca. El propio correo advierte: “If you rely on the watermark for your own compliance, keep these settings at their defaults”. Para Mythos 5 y Opus 4.7 esa salvedad no aparece, lo que sugiere que en esos dos la marca aplica sea cual sea la configuración.
Por qué ahora
El EU AI Act obliga desde el 2 de agosto a marcar de forma legible para máquina el contenido generado, y los sistemas en el mercado antes de esa fecha tienen hasta el 2 de diciembre. Anthropic publicó en su página de marca de agua que los modelos lanzados después del 2 de agosto ya nacen marcados y que los anteriores se van a incorporar “over the coming months”.
El centro de ayuda de Claude, que la empresa dice haber actualizado esta semana, muestra el estado modelo por modelo: con marca de texto aplicada figuran Fable 5.1, Fable 5, Mythos 5.1, Opus 5.5, Opus 5 y Opus 4.8, además de Sonnet 5.5, Sonnet 5 y Haiku 5.5; Mythos 5, Opus 4.7, Opus 4.6, Sonnet 4.6, Opus 4.5, Sonnet 4.5 y Haiku 4.5 siguen listados solo con Content Credentials (C2PA) en archivos. Es decir, la tabla pública todavía no refleja el despliegue que describe el correo.
Cómo funciona y qué no prueba
Anthropic describe la marca como un patrón imperceptible en la elección de palabras, sin caracteres agregados, sin tokens extra, sin costo adicional y sin información sobre el usuario, su organización o sus conversaciones. Técnicamente es una variante del método SynthID-Text que Google DeepMind publicó en Nature en 2024, de la familia de propuestas que van de la idea de Scott Aaronson de 2022: solo cambia la fuente de la aleatoriedad con la que se elige la siguiente palabra.
La empresa es explícita sobre los límites: la marca solo determina que Claude “was likely involved” y no distingue entre escribir y editar un texto; una reescritura completa la elimina. Heise añade que, una vez aplicada, no puede desactivarse por el usuario y que el disparador es la regulación europea aunque el efecto sea mundial, porque la marca se emite en todas las plataformas que alojan los modelos, incluidas AWS, Google Cloud y Microsoft Foundry. La API de detección está en vista privada para reguladores, fuerzas de seguridad, medios, verificadores e investigadores.
El despliegue, los parámetros y las advertencias salen del correo de Anthropic reportado por The Decoder; el estado por modelo lo tomamos del centro de ayuda de la empresa, y el contexto regulatorio y técnico de la página oficial de Anthropic y de Heise.