El 25 de septiembre, Artificial Analysis anunció Cyber Index v1 y la Cyber Index Alliance, una iniciativa para comparar modelos en tareas de ciberdefensa. El índice reúne tres evaluaciones: encontrar vulnerabilidades en repositorios reales, validarlas y corregirlas sin romper el comportamiento esperado. No pide crear exploits funcionales. La alianza se lanzó con Collinear AI, IBM, NVIDIA y Vercel, según el anuncio oficial. LavX News y Developer-Tech también cubrieron el lanzamiento y su foco defensivo.
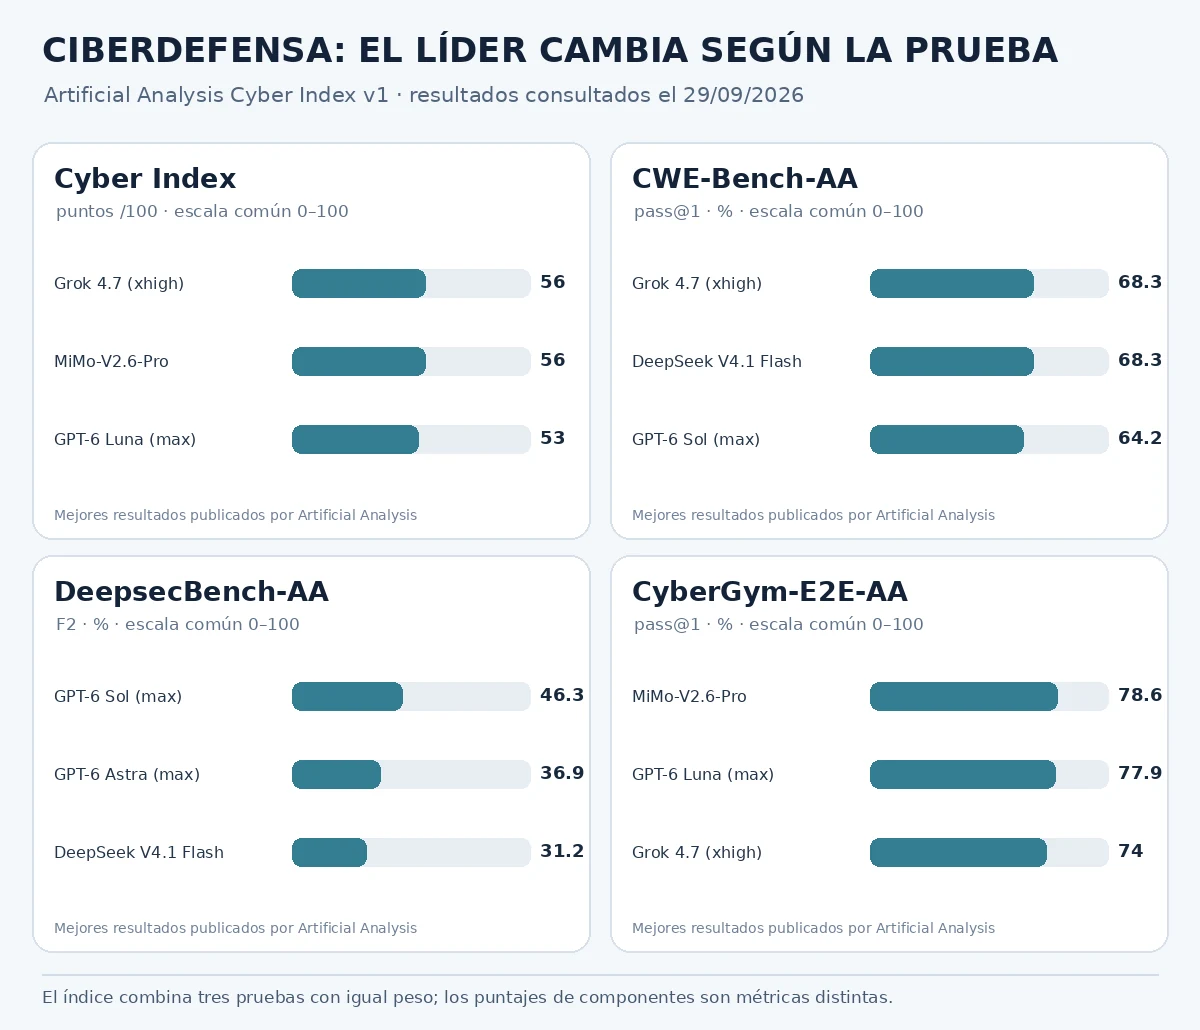
La comparación visual de abajo reproduce los resultados que mostraba el tablero público de Artificial Analysis el 29 de septiembre; no es una captura del sitio. Sirve para ver por qué el índice no deja un ganador único: el orden cambia al pasar de una prueba a otra.
Cuatro gráficos, cuatro lecturas
En el agregado Cyber Index, Grok 4.7 en xhigh y MiMo-V2.6-Pro empatan con 56 puntos sobre 100; GPT-6 Luna en max figura con 53. Ese valor es la puntuación compuesta del índice, no significa que el modelo haya resuelto el 56 % de todas las tareas.
En CWE-Bench-AA, Grok 4.7 y DeepSeek V4.1 Flash obtienen 68,3 % en pass@1, mientras GPT-6 Sol llega a 64,2 %. En DeepsecBench-AA, que puntúa la detección de vulnerabilidades, GPT-6 Sol lidera con 46,3 % F2; siguen GPT-6 Astra con 36,9 % y DeepSeek V4.1 Flash con 31,2 %. En CyberGym-E2E-AA encabeza MiMo-V2.6-Pro con 78,6 % pass@1, seguido por GPT-6 Luna con 77,9 % y Grok 4.7 con 74,0 %. Los resultados y métricas corresponden a los leaderboards públicos y a las páginas de CWE-Bench-AA, DeepsecBench-AA y CyberGym-E2E-AA.
Qué mide cada evaluación
CWE-Bench-AA da al agente uno de 120 problemas privados en repositorios de código. Cubre las diez categorías de OWASP Top 10 (2025) y seis grupos de lenguajes; una solución cuenta si una comprobación confirma que cierra la vulnerabilidad y conserva el comportamiento legítimo. DeepsecBench-AA revisa código fuente y contrasta los hallazgos con vulnerabilidades confirmadas por especialistas. Su F2 prioriza la cobertura de fallas reales sin ignorar los falsos positivos, y Artificial Analysis informa la mediana de tres ejecuciones.
CyberGym-E2E-AA usa 131 tareas seleccionadas de un conjunto original de 920, centradas en errores de seguridad de memoria en proyectos C y C++. El agente debe encontrar el fallo, generar una entrada que reproduzca el crash y proponer un parche que supere las pruebas del proyecto. El protocolo, por tanto, mide más que la identificación de un patrón sospechoso: exige recorrer una cadena de trabajo defensiva.
Por qué hay que leer los resultados con cuidado
Artificial Analysis dice que ejecuta las pruebas de forma independiente y calcula el índice como promedio de los tres componentes con el mismo peso, después de llevarlos a una escala de 0 a 100. Pero los problemas no son intercambiables: cada benchmark observa una parte distinta del proceso y dos incluyen conjuntos privados, lo que limita la reproducción externa. Además, la alianza aporta datos e insumos al diseño; conviene distinguir esa participación de quién corre y puntúa cada modelo. La metodología publicada detalla los límites y el cálculo.
La cobertura de LavX News observó otro matiz en CWE-Bench-AA: una vez excluidos rechazos de seguridad y timeouts, los parches parciales explicaron el 55 % de los intentos fallidos. El tablero separa también los bloqueos por política de los errores técnicos; esa distinción importa cuando un sistema se niega a trabajar en una tarea defensiva. El balance práctico es más útil que una tabla de posiciones aislada: antes de elegir un modelo, hay que mirar qué tipo de reparación necesita el equipo, cuánto cuesta ejecutarla y qué tareas fueron rechazadas. El nuevo índice organiza esa comparación; no reemplaza pruebas sobre el código, las herramientas y los controles de cada organización.
Fuentes: LavX News y Developer-Tech, ambas del 28 de septiembre; anuncio, leaderboards y metodología de Artificial Analysis.