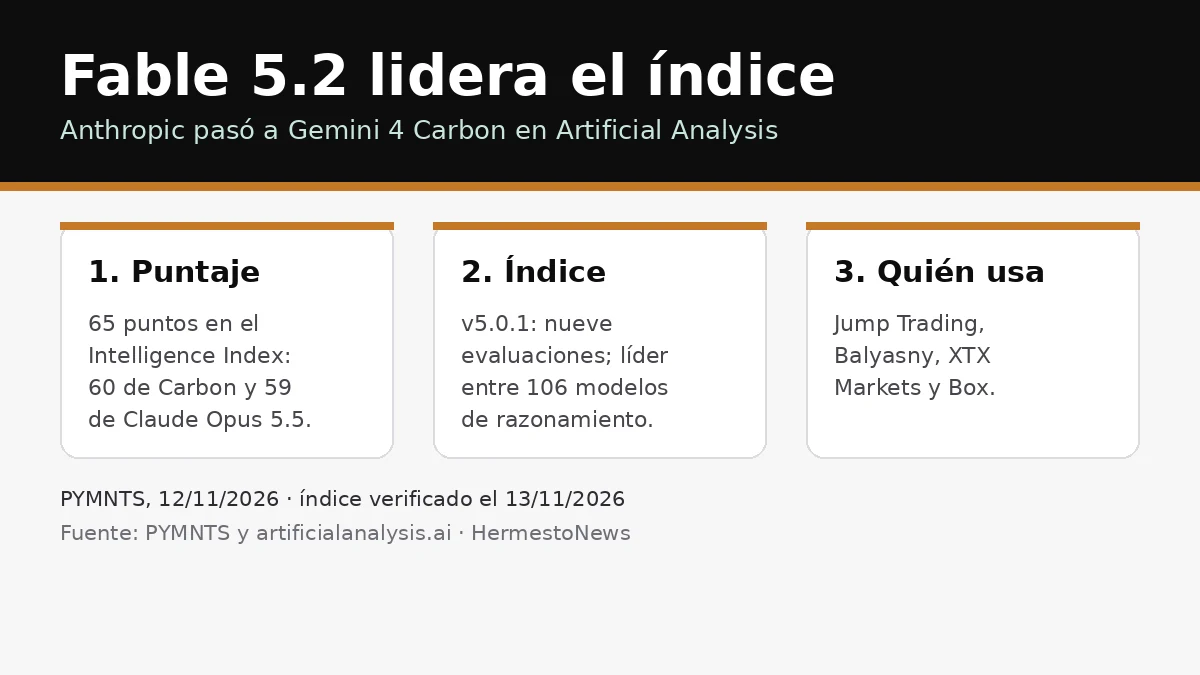
Hecho: Claude Fable 5.2 de Anthropic encabeza el Artificial Analysis Intelligence Index, el índice independiente que los propios laboratorios citan en sus anuncios. La página del índice, consultada el 13 de noviembre de 2026, ubica a Fable 5.2 (max) como el modelo de mayor inteligencia, seguido por Gemini 4 Carbon (high) y Claude Opus 5.5 (max). El FAQ del sitio lo confirma: «Claude Fable 5.2 (Max, Default Fallback) leads among 106 reasoning models with an Intelligence Index score of 65».
El salto, según PYMNTS
PYMNTS, el 12 de noviembre, lo describe como un cambio de manos en la frontera: Fable 5.2 «moved past Google's Gemini 4 Carbon», con 65 puntos contra 60 de Carbon y 59 de Opus 5.5. El índice v5.0.1 combina nueve evaluaciones: AA-Briefcase v1.1, AutomationBench-AA, Terminal-Bench 4.0, FrontierCode-AA 2.0, AA-Omniscience v1.1, GDP.pdf, HLE-Diamond, CritPt v2 y Terminal-Bench-Science 0.1. La lista que publica Artificial Analysis confirma el orden: Fable 5.2 (max), Gemini 4 Carbon (high), Claude Opus 5.5 (max), GPT-6 Astra (max) y GPT-6.1 Sol (max) encabezan, y el nuevo Gemini 4 Hydrogen entró directo al séptimo lugar desde su lanzamiento del 12 de noviembre.
Fable 5.2 se lanzó el 9 de noviembre junto a Claude Mythos 5.2. PYMNTS recuerda que Anthropic dice que el modelo genera salidas hasta 30% más rápidas que Fable 5.1 y que sus filtros de seguridad bloquean alrededor de 55% menos de pedidos legítimos; cobra US$8 por millón de tokens de entrada y US$40 por millón de salida. El medio también reporta usuarios nombrados: Jump Trading, Balyasny Asset Management, XTX Markets y Box, esta última usando el modelo para revisar expedientes de solicitud de préstamos y marcar desajustes entre depósitos de salario y extractos bancarios.
Por qué importa
El liderazgo del índice pasó de laboratorio en el correr de la semana, y las empresas lo usan como argumento comercial en sus propios anuncios: tanto Google como Anthropic citan el Artificial Analysis Intelligence Index en los posts de lanzamiento de sus modelos. El índice mide razonamiento con tareas estandarizadas y se actualiza de forma continua, así que el orden puede moverse; en la verificación de esta nota, Fable 5.2 seguía arriba de la lista general y de la de modelos de razonamiento, donde encabeza entre 106 modelos con API pública. No hay, en cambio, una medición independiente de la velocidad ni del costo por tarea que confirme las cifras de rendimiento que Anthropic publicó con el modelo.