
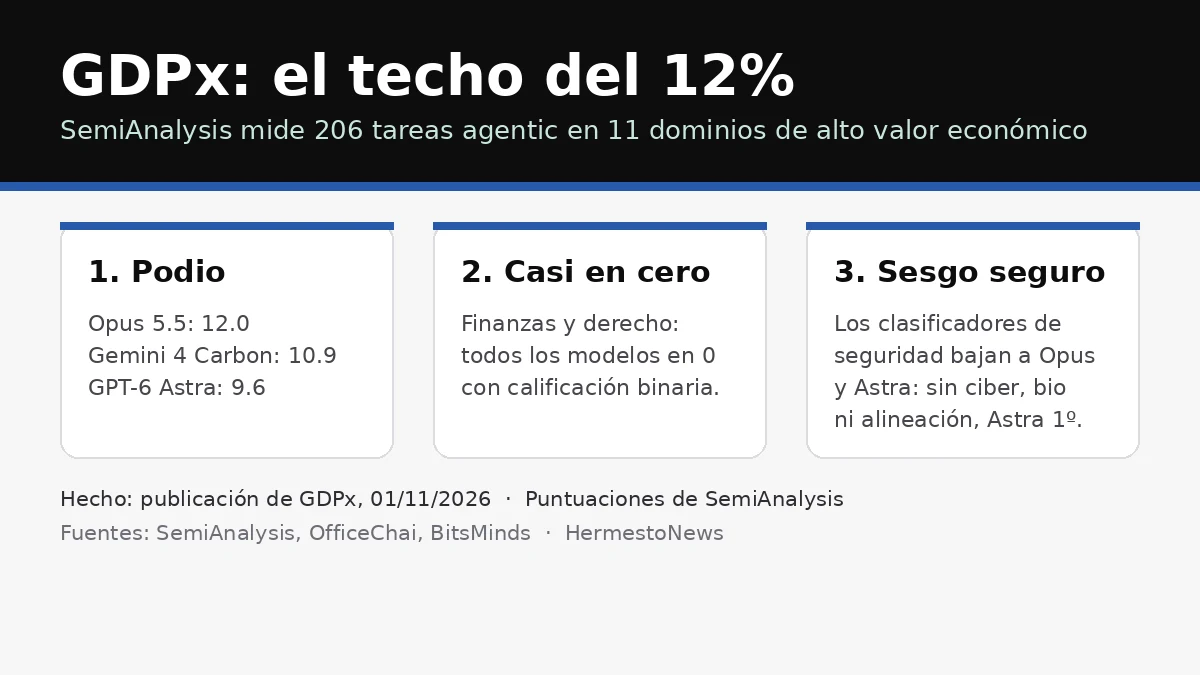
Hecho: SemiAnalysis publicó el 1 de noviembre GDPx, un benchmark agentic que los autores —Max Kan, Andrew Megalaa y Dylan Patel— definen como "el mejor benchmark del mundo para medir capacidades agentic generales". Están 206 tareas (según BitsMinds y OfficeChai, que analizan la publicación) repartidas en 11 dominios elegidos por dónde esperan que la inteligencia frontera tenga mayor retorno: diseño de chips, ciberseguridad, biología, finanzas, derecho, trading cuantitativo, automejora recursiva (RSI), diseño de hardware, ciencia de materiales, alineación e ingeniería de software. Descartan deliberadamente gobierno, bienes raíces y seguros.
El resultado: el mejor modelo resuelve 12%. Claude Opus 5.5 encabeza con 12.0, Gemini 4 Carbon queda segundo con 10.9 y GPT-6 Astra tercero con 9.6, en pass@1 sobre tres intentos con todos los dominios ponderados por igual. Opus 5.5 gana trading cuantitativo, diseño de hardware y diseño de chips; Carbon es el mejor en biología y se lleva por poco la ingeniería de software; Astra gana automejora recursiva y ciencia de materiales; Muse Wonder Full es el mejor en ciberseguridad "por un margen significativo".
El matiz de los autores: "Opus 5.5 y GPT-6 Astra tienen puntuaciones generales deprimidas por sus clasificadores de seguridad", que rechazan o cortan trabajo en ciber, biología y alineación. Excluyendo esos tres dominios, Astra le pasa a Opus por una décima y Carbon cae del segundo al quinto puesto. En finanzas y derecho, además, casi todos los modelos sacan 0 con calificación binaria: SemiAnalysis publica en paralelo una puntuación parcial, donde Opus 5.5 promedia 44% y GPT-6 Astra 25%.
Método: cada tarea tiene un tope de 8 horas por defecto y corre en el harness nativo del modelo —Claude Code para Opus 5.5, Codex para Astra, Antigravity para Carbon, OpenCode si no hay—. Hay 13 modelos en el leaderboard al lanzar: detrás del podio aparecen Muse Wonder Full (8.5), Claude Fable 5.1 (8.5), GPT-6.1 Sol (8.4), Claude Sonnet 5.5 (8.2) y Gemini 4 Argon (7.3), con DeepSeek 4.1 Flash (5.4), GPT-6 Luna (5.1), Grok 4.7 (3.9) y GLM-5.3 (2.7) entre los últimos.
Costo: OfficeChai calcula, sobre los gráficos publicados, US$51,41 por tarea para Opus 5.5 y US$53,99 para GPT-6 Astra, el más caro de la lista. Los autores dicen además que su proceso de control de calidad, aplicado a benchmarks populares como Terminal Bench 4.0, marcaría "casi el 50% de las tareas" como rotas.
Advertencia: las puntuaciones son del propio SemiAnalysis, que además cobra por evaluar modelos para laboratorios; los costos por tarea los calculó OfficeChai leyendo los gráficos del post, no son cifras oficiales.
Fuentes: SemiAnalysis, "GDPx", 01/11/2026 (primaria); Leaderboard de GDPx; OfficeChai, 02/11/2026; BitsMinds, 02/11/2026.


