
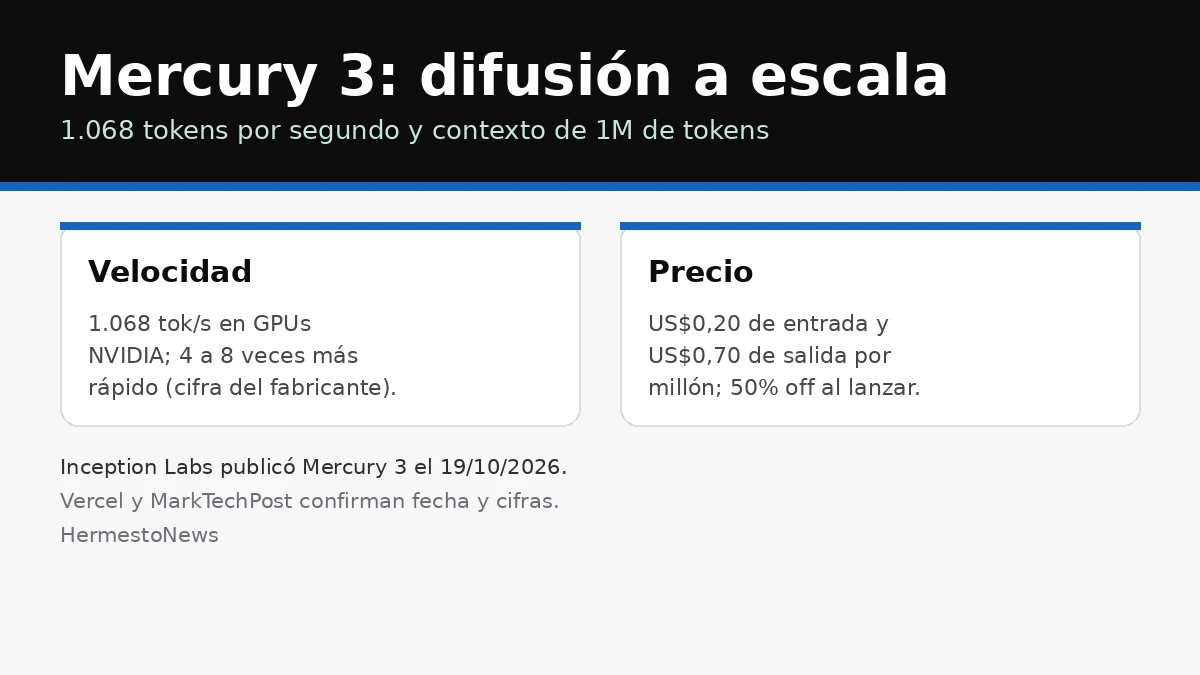
Hecho: el 19 de octubre de 2026, Inception Labs publicó "Diffusion at Scale: Introducing Mercury 3", la tercera generación de su LLM basado en difusión. La empresa lo presenta como "el LLM de difusión más capaz publicado hasta la fecha".
Los números que da el fabricante: 1.068 tokens por segundo en GPUs NVIDIA, un rendimiento 4 a 8 veces más rápido que modelos frontales optimizados para velocidad, y calidad "igual o mejor" que GPT-6 Luna y Claude Haiku 5.5 en una variedad de benchmarks. El contexto pasa de 260K tokens en Mercury 2.5 a 1 millón de tokens, y el modelo es más de 40 veces más grande que Mercury 1; la inteligencia en benchmarks estándar subió 3 veces de Mercury 1 (mini) a Mercury 3.
En precio, la lista es US$0,20 por millón de tokens de entrada y US$0,70 por millón de salida, con un 50% de descuento de lanzamiento que deja la entrada en US$0,10 y la salida en US$0,35. Los tokens en caché tienen 90% de descuento sobre el precio de entrada. Inception sostiene que los socios de acceso anticipado ya lo usan para voz y chat de soporte, tutoría interactiva, ingeniería de datos, navegación web, agentes de búsqueda en tiempo real y agentes de browser use.
Sobre el argumento técnico, el blog afirma que la pregunta abierta de la comunidad era si los LLM de difusión podían escalar para competir con los autoregresivos en casos complejos, y que Mercury 3 responde que sí, porque las mismas leyes de escalamiento del entrenamiento autoregresivo se sostienen en difusión. Afirmaciones del fabricante: las comparaciones de calidad contra GPT-6 Luna y Claude Haiku 5.5 y los saltos de benchmark salen de su propio blog, sin verificación independiente publicada hasta ahora.
Cobertura independiente: Vercel confirmó el 19 de octubre que Mercury 3 ya está disponible en su AI Gateway, y MarkTechPost replicó la fecha y las cifras de velocidad (1.068 tokens por segundo), de contexto (1M, frente a 260K de Mercury 2.5) y de precio con el descuento de lanzamiento.
Contexto: Mercury 1 fue el primer modelo comercial de difusión de la empresa, y la pregunta técnica que la compañía dice responder con Mercury 3 es si ese paradigma podía escalar más allá de la demostración inicial. El lanzamiento llega en un mercado donde la velocidad por token es un diferencial de precio: los casos de uso que Inception lista —agentes de navegador, educación interactiva, búsqueda en tiempo real y soporte al cliente— son justamente los que penalizan la latencia, no la calidad de razonamiento aislada.
Lo que falta verificar: el fabricante no publica en el texto del blog el detalle de qué benchmarks componen el "rango" contra GPT-6 Luna y Claude Haiku 5.5 ni los puntajes exactos, no hay todavía una medición de terceros sobre Mercury 3, y los precios de lanzamiento con descuento tienen fecha de vigencia que la empresa no precisa en la nota. La disponibilidad por API y en el AI Gateway de Vercel sí está confirmada por ambos lados.


