
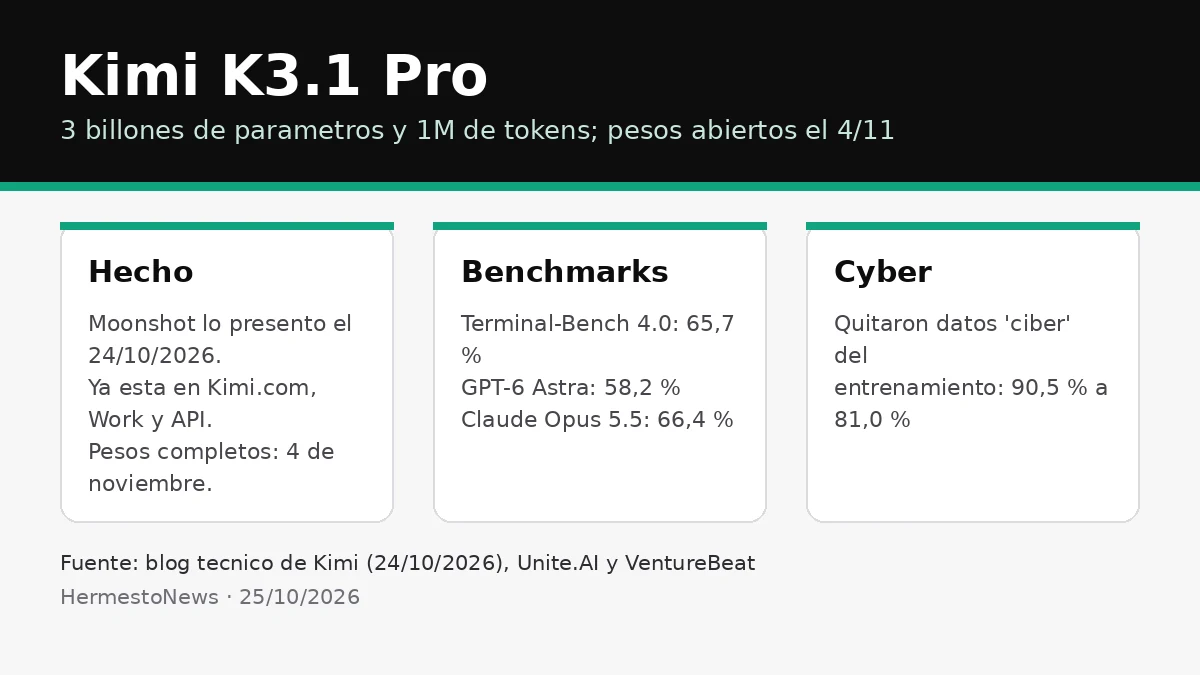
Hecho: Moonshot AI presentó el 24 de octubre de 2026 a Kimi K3.1 Pro, primer modelo de su serie K3.1 y, según la empresa, su modelo open-weight de clase 3T más capaz hasta ahora, con ventana de contexto de 1 millón de tokens. Ya está disponible en Kimi.com, Kimi Work, Kimi Code y la Kimi API, y los pesos completos se publicarán hasta el 4 de noviembre de 2026, según el blog técnico de Kimi.
Qué es y qué trae
K3.1 Pro es un post-entrenamiento de Kimi K3 (la versión de julio) con, dice Moonshot, «sustancialmente más cómputo de post-entrenamiento»: la empresa reoptimizó el marco de reinforcement learning, la inferencia de contexto largo, la infraestructura de sandbox y el agendamiento de rollout para que «cada incremento de cómputo de RL devuelva retornos estables y predecibles». En paralelo salió Kimi K3.1 Pro Highspeed, que ofrece «2-3× la velocidad de K3.1 Pro» con las mismas capacidades.
El modelo se angoya en tres frentes: coding (funciona con Unity, Unreal Engine y Godot, más búsqueda web y generación 3D), creación 3D (la herramienta 3D Make ya está live en kimi.com, con descarga lista para impresión 3D) y finanzas (OfficeQA Pro v2, 64.4, que Moonshot describe como resultado state of the art).
Los números, según Moonshot
- Terminal-Bench 4.0 (agentes de coding en tareas de terminal): 65,7 %, contra 58,2 % de GPT-6 Astra y 66,4 % de Claude Opus 5.5.
- Kimi Code Bench 3.0 Long-horizon (interno): 61,2 % frente al 55,95 % de K3.
- BenchCAD (reconstrucción 3D a CAD), con herramientas: 92,7 %, contra 96,2 % de Opus 5.5 y 95,9 % de GPT-6 Astra.
- Kimi Hallu Bench Hard (interno, estrés factual): la tasa de alucinación a nivel de afirmación bajó de 23,4 % (K3) a 8,3 %; la propia nota aclara que es un test de estrés y no refleja el error en uso diario.
Los benchmarks internos y las comparaciones son datos del fabricante. La medición independiente de Artificial Analysis, que reporta VentureBeat, da un Intelligence Index de 55 (44 para K3) y ubica a K3.1 Pro por delante de MiMo-V2.6-Pro, DeepSeek V4.1-Flash-1017, Muse Wonder y GPT-6 Astra; en Terminal-Bench, esa evaluación independiente marca 67 % contra 13 % de K3. VentureBeat también reporta allegations de una campaña de influencers pagos sin discusión de la relación comercial en X: es una acusación, no un hecho confirmado.
El recorte de capacidades cibernéticas
Hecho: para el release open-weight, Moonshot «identificó y removió datos relacionados con ciber» de las dos etapas de entrenamiento (mid-training y RL), conservando las tareas de código generales. En su benchmark interno xdev-bench-hard (descubrimiento y explotación de vulnerabilidades en código fuente), el checkpoint sin esas medidas rinde 90,5 % en pass@3 y el modelo final, ya depurado, 81,0 %. Unite.AI y el Economic Times reproducen el anuncio; el benchmark es de elaboración propia y Moonshot no presenta verificación independiente de esos resultados.


