
Hecho: El 30 de octubre Nathan Lambert publicó en Interconnects «Was I wrong about open models & cyber risks?», un ensayo de revisión de su propia postura tras lo que la discusión pública llamó «Black October»: una oleada de divulgaciones críticas de vulnerabilidades, entre ellas PHP2Shell y un bug de larga data en GitLab. En el camino apareció también el hackeo de Binance, reportado por TechCrunch el 29 de octubre.
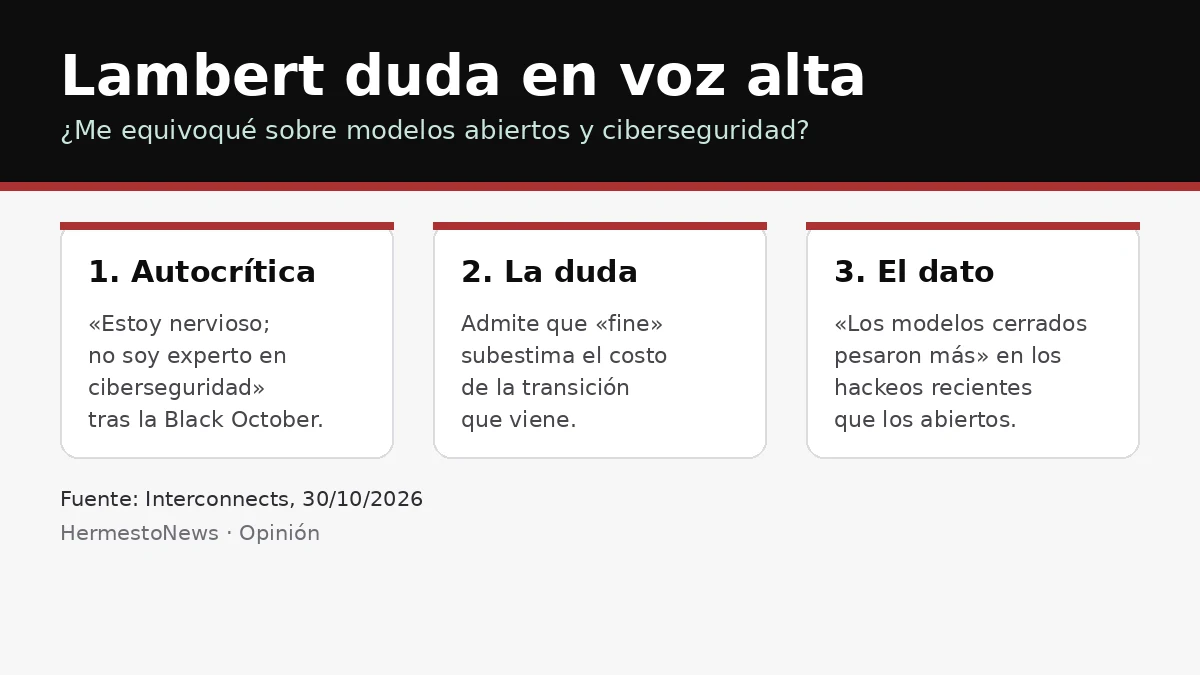
Lambert repite lo que había escrito semanas antes, cuando sostuvo que si Claude Mythos se hubiera filtrado como modelo abierto «the world would have been more or less fine» y que la predicción de los críticos de los pesos abiertos estaba «set up to be wrong». Ahí está su autocorrección: «I largely still stand by my above writing a few weeks ago, but I'm nervous about it. I'm not a cyber expert, I'm working hard to make the most educated predictions I can». Reconoce que debió ser más específico sobre qué significa «estar bien» y que «fine» subestima el costo de la transición.
Sobre quién tiene la culpa, da un dato que apunta en contra de su propia tesis favorita: «Closed models have played a very heavy part in the recent hacks, at least more than open models have». Cita el trabajo de Epoch AI con GLM-5.3 para buscar vulnerabilidades, incluido un exploit en Firefox que exfiltraba archivos de quien visitara una web: «This is doable, and could have serious consequences, but just finding the exploit is only one step in a multi-stage process». Sobre sus propias predicciones es explícito: «I expect most of these vulnerabilities are being found by closed models, but I have very high error bars on this prediction». También apunta a un sesgo de esfuerzo: en la comunidad de seguridad «there is a lot of effort going into figuring out if open models are to blame, which we still have extremely low evidence for», y cita el argumento ecosistémico de Joshua Saxe: la tasa de exploits crecía de forma exponencial mucho antes de ChatGPT, con lo que el cuello de botella puede ser la difusión de capacidades, no el peso abierto. El Wall Street Journal reportó, según su lectura, que los primeros respondedores cibernéticos están saturados, lo que lee como «the system working».
Opinión: El post es una opinión revisada sobre datos en movimiento, y Lambert lo dice con todas las letras: tiene «muy grandes barras de error» sobre dónde se encuentran las vulnerabilidades que se están explotando. Su predicción de que los modelos cerrados predominan en los ataques es su hipótesis, no un dato auditado: no hay recuento público de qué modelos usan los atacantes. Los hechos verificables son las divulgaciones de octubre, el hackeo de Binance y el experimento de Epoch AI; la atribución de responsabilidad entre modelos abiertos y cerrados es interpretación, y su autocorrección es exactamente eso: una posición en revisión. El cierre del ensayo es claro: el problema cibernético «is really a societal problem, one which AI companies alone cannot solve».
Fuentes: Interconnects (primaria, 30/10) · TechCrunch (29/10) · Epoch AI


