
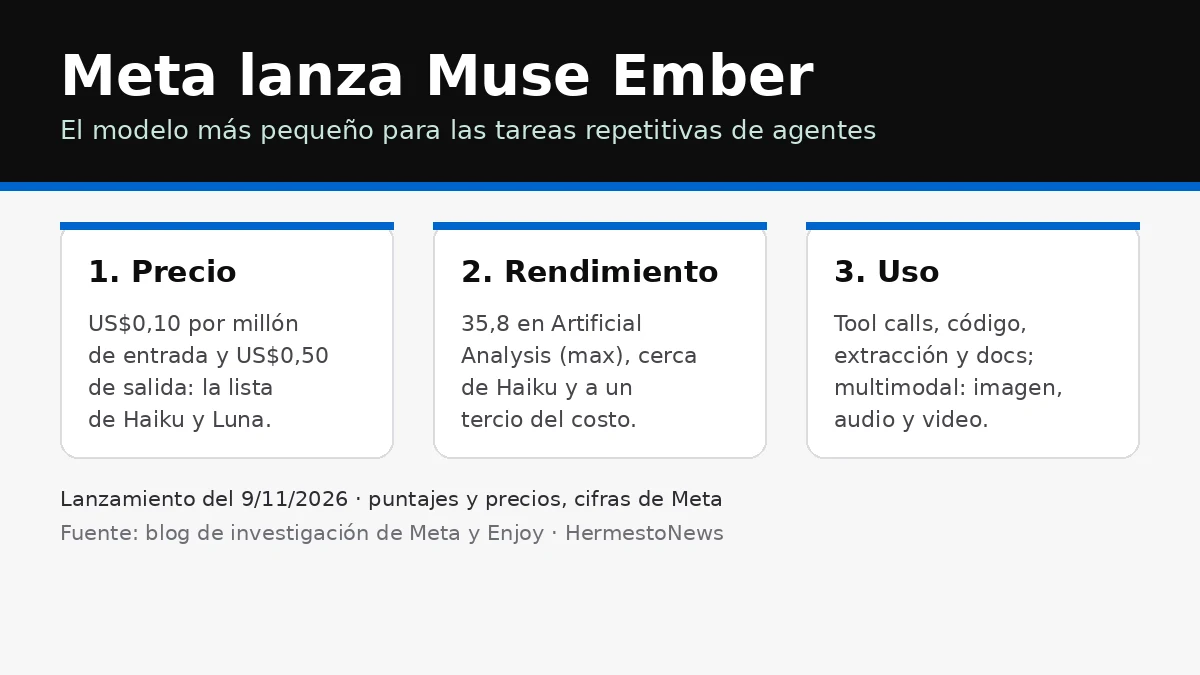
Hecho: Meta lanzó el 9 de noviembre de 2026 Muse Ember, «nuestro modelo más pequeño y eficiente», pensado para «trabajo complejo de ejecución de razonamiento y las tareas que los agentes repiten todo el día: llamadas a herramientas, subtareas de código, routing, extracción y parseo de documentos largos», según el blog de investigación de la empresa.
Está disponible en Meta Model API y en Muse Code con el identificador muse-ember-1.0, y acepta entradas de texto, imagen, audio y video. Los primeros socios de pruebas citados por Meta son Box, Cline, Oracle, Cloudflare y You.com.
Precio y comparaciones (cifras del fabricante)
Meta lista US$0,10 por millón de tokens de entrada y US$0,50 por millón de salida, el mismo precio de lista que Claude Haiku 5.5 y GPT-6 Luna, y sostiene que Ember «delivers more intelligence per dollar than Claude Haiku 5.5 or GPT-6 Luna at any reasoning setting»: igualaría el mejor puntaje de Haiku a cerca de un tercio del costo por tarea y le ganaría a todos los settings de Luna.
El gráfico del post, tomado de Artificial Analysis con fecha 9 de noviembre, da los números: Ember en max puntúa 35,8 con un costo por tarea de US$0,136; Haiku 5.5 en max, 36,2 a US$0,411; GPT-6 Luna en max, 27,8 a US$0,152. En las evaluaciones que Meta cita, AutomationBench-AA da 37,8 contra 13,9 de Haiku y 20,2 de Luna, y Terminal-Bench 4.0 da 40,9 contra 39,2 y 16,4. Pierde en FrontierCode 2.0: 27,2 frente a 34,9 de Haiku.
El cuadro completo del post también da Agents' Last Exam (61,6 contra 57,0 y 57,1), el índice interno de trabajo personal y de conocimiento (46,8 contra 36,1 y 37,0) y el Coding Agent Index-AA (46 contra 37 y 31). En documentos largos (GDP.pdf-AA) empata con Luna en 22,8 y queda apenas por encima de Haiku (20,8). El punto débil declarado es el conocimiento: Enjoy, que reseñó el lanzamiento, cita el informe del modelo diciendo que Ember responde bien el 21,1% de las preguntas de AA-Omniscience y que en buena parte de los casos simplemente se abstiene.
Límites
El modelo no es de pesos abiertos y Meta no publicó cuántos parámetros tiene; la empresa solo dice que «tenemos modelos aún más eficientes en entrenamiento». Shengjia Zhao, chief scientist de Meta MSL, explicó en X que Ember está «designed for the work agents repeat all day» y remitió al blog de investigación. La propuesta de arquitectura es clara en el material de Meta: Ember ejecuta los pasos repetitivos mientras un modelo mayor, como Muse Wonder, planifica.


