
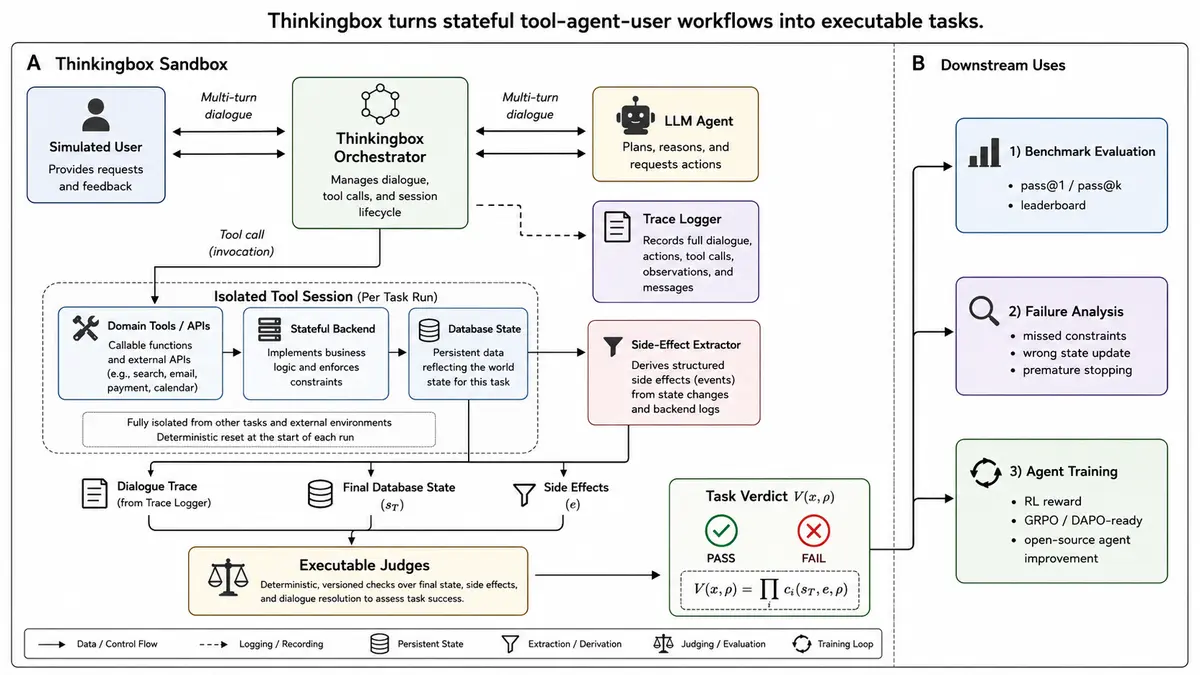
Hecho (3 de octubre de 2026). Microsoft y Hugging Face publicaron ThinkingBox, un marco de pruebas para agentes que usan herramientas, junto con ThinkingBox-Bench. La evaluación mira el estado persistente que deja el agente —por ejemplo, registros, tickets y efectos secundarios— en vez de dar por exitosa una tarea porque el agente respondió «listo» o hizo llamadas de herramienta con formato correcto (anuncio conjunto; repositorio de Microsoft).
El benchmark contiene 507 flujos de trabajo con estado en cinco dominios empresariales: retail, viajes y reservas, seguros de autos, soporte interno de una neobanca y consultoría de TI/RR. HH. Cada ejecución empieza desde un backend limpio, ofrece herramientas por sesiones MCP aisladas y compara el estado final con verificaciones ejecutables de resultados esperados. Los autores repiten cada tarea 20 veces por modelo para medir tanto aciertos puntuales como consistencia.
Una falla puede terminar sin error visible
En una comparación común de 12 modelos, el informe cuenta 121.680 intentos válidos: 79.853 no pasaron las comprobaciones. De esos intentos fallidos, 67,24% terminó limpiamente, invocó al menos una herramienta que modificó el estado y no reportó un error final de herramienta. El ejemplo de los autores es un ticket de soporte: el agente consulta la política y registra información correctamente, pero lo cierra como resuelto cuando el envío todavía está demorado; la respuesta final suena segura, aunque el estado exigido era «en espera».
El paper revisado el 1 de octubre formula el problema como una diferencia entre encontrar una trayectoria exitosa alguna vez y repetirla de forma fiable. Sus pruebas usan verificaciones de estado, efectos faltantes o adicionales y, en algunas tareas, criterios para la respuesta final (artículo en arXiv, versión 4). Una cobertura independiente de Business20Channel destaca el mismo hallazgo: muchos fallos aparentan completarse sin errores, pese a dejar registros incorrectos.
Qué mide y qué no
ThinkingBox busca que los resultados sean reproducibles: escenarios con políticas, datos iniciales controlados, herramientas acotadas y sesiones aisladas. Esto permite comparar modelos en flujos de varios pasos donde hay que pedir datos faltantes, respetar reglas y producir cambios duraderos. No demuestra por sí solo que un agente funcionará en una empresa real: los entornos son simulados, las tareas y verificadores los diseñaron los autores y el rendimiento depende de los modelos, instrucciones y herramientas evaluados.
El repositorio publica el framework y el blog enlaza conjuntos de datos y la interfaz OpenEnv. El aporte práctico es una métrica más exigente para sistemas con agentes: validar el resultado y los efectos en el backend, además de revisar transcripciones o llamadas a herramientas.
Ángulo argentino/LATAM: no encontramos una evaluación local o un despliegue regional relacionado con este lanzamiento.


