
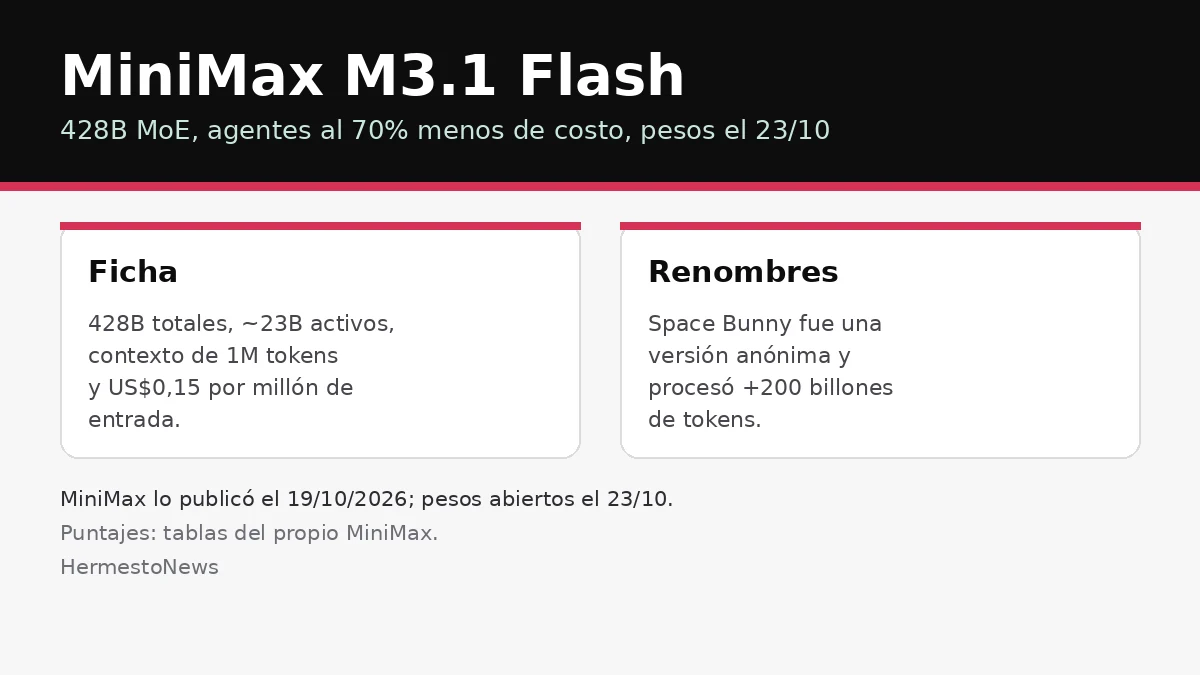
Hecho: el 19 de octubre de 2026, MiniMax publicó en su blog "MiniMax M3.1 Flash: Redefining Agent Performance and Cost" y abrió el modelo en su API. La página del producto lo lista como un modelo mixture-of-experts de 428B de parámetros totales y unos 23B activos, con ventana de contexto de 1 millón de tokens.
El comunicado afirma que la inferencia en línea es casi tres veces más rápida y que los costos de uso bajan 70%. Además revela que "Space Bunny", un modelo que operó de forma anónima, fue una versión temprana de M3.1 Flash y procesó más de 200 billones de tokens antes de identificarse.
Los benchmarks citados son del fabricante: figuran entre los mejores desempeños en AutomationBench-AA para tareas agénticas complejas, 76,2 en BankerToolBench (planificación por pasos, consistencia documental, cumplimiento financiero y encadenamiento de herramientas) y 73,7% en DeepSWE v1.1 para tareas de software. MarkTechPost agrega, de la misma tabla de MiniMax, un 62,2 en Automation-Bench v1.0.6 como mejor puntaje propio y un 38,1 en Terminal Bench 4.0 frente al 51,8 de Opus 5, es decir, que el modelo queda por detrás en código difícil.
Cobertura independiente: Vercel confirmó que M3.1 Flash está disponible en su AI Gateway y The New Stack analizó el recorte de precios por token con una salvedad: que la baja del precio de lista no necesariamente se traslada a la factura final de un agente en producción, porque ahí pesan más las llamadas de herramientas, el reintentos y la longitud de las respuestas.
MiniMax dice además que el modelo mejora de forma transversal en tareas agénticas, código, computer use y ciberseguridad, y que los pesos abiertos se publican el 23 de octubre de 2026. Hasta esa fecha, la disponibilidad es por API (MiniMax API, Plan y MiniMax Code), tal como confirma también el changelog de Vercel.
La lectura de conjunto que proponen los medios independientes es de costo, no de régimen: MarkTechPost lo resume como "puntuaciones agénticas casi de frontera al costo de la gama Flash", y The New Stack matiza que el recorte de precios de lista no garantiza un ahorro proporcional en la factura real de un agente en producción, porque ahí pesan tanto el modelo como las llamadas a herramientas, los reintentos y la longitud de las respuestas. El diferencial de precio que publica MiniMax es de US$0,15 por millón de tokens de entrada, con un modelo que, con428B de parámetros, igual tiene que servirse en infraestructura propia si se corre localmente.
Lo que falta verificar: los puntajes de AutomationBench-AA, BankerToolBench, DeepSWE v1.1 y Terminal Bench 4.0 salen de tablas del propio MiniMax; no hay aún una evaluación independiente publicada sobre M3.1 Flash, y el dato de que Space Bunny procesó más de 200 billones de tokens en modo anónimo tampoco es verificable desde afuera.


