
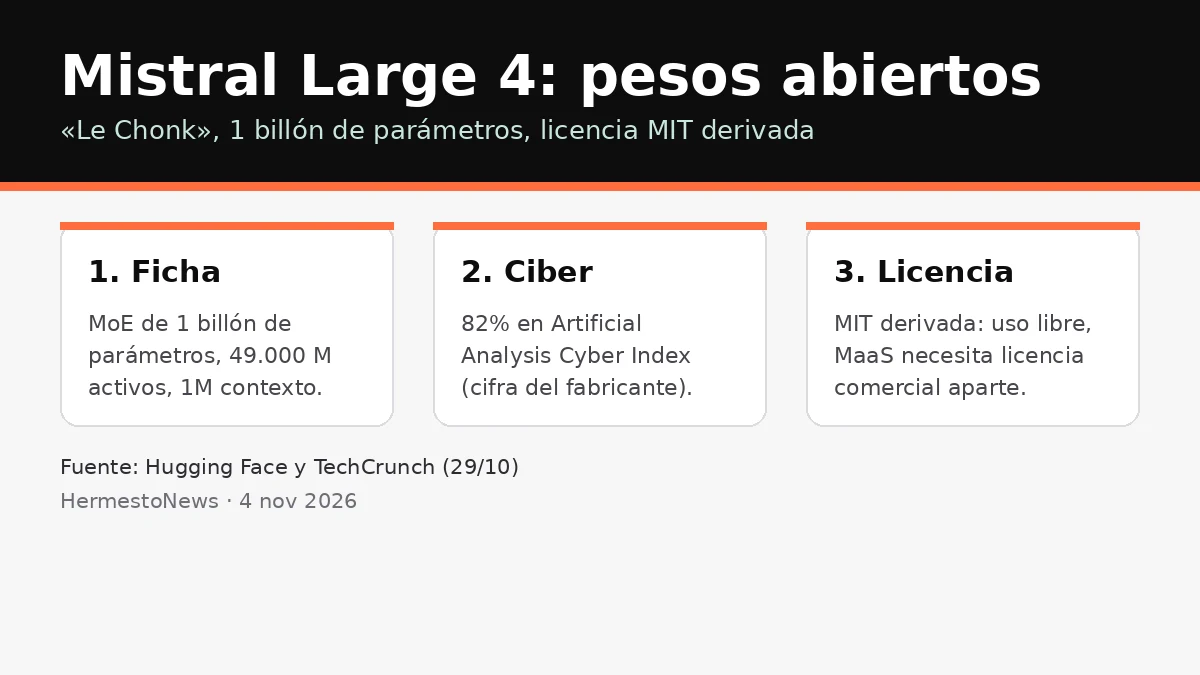
Hecho: Mistral publicó el 29 de octubre los pesos de Mistral Large 4, apodado «Le Chonk», tres semanas después de la vista previa del 6 de octubre. El modelo quedó disponible en Hugging Face como mistralai/Mistral-Large-4-1T-A52B, con dos variantes oficiales (FP8 y NVFP4) y GGUF preparados por Unsloth y el equipo de llama.cpp. También sigue accesible por API, en Mistral Studio y en OpenRouter.
Ficha, según Hugging Face y Mistral: modelo multimodal y multilingüe de mezcla de expertos (MoE) con unos 1 billón de parámetros totales, 49.000 millones activos por token, contexto de 1 millón de tokens, entrada de texto e imagen y salida de texto. La licencia es la Mistral Ecosystem Open-Weight License, una derivada de MIT que deja libre el uso y la modificación pero exige una licencia comercial separada para quien quiera ofrecerlo como servicio alojado (Model-as-a-Service).
El foco declarado es la ciberseguridad defensiva. En el blog de Hugging Face, Mistral sostiene que Large 4 saca 82% en el Artificial Analysis Cyber Index, una prueba que pide al modelo reproducir una vulnerabilidad real de software libre y parchearla, y que varios modelos frontera cerrados quedan cerca de cero porque se niegan a hacer el trabajo. Mistral agrega que en sus pruebas internas el modelo también sirvió para análisis de malware, priorización de vulnerabilidades y redacción de reglas de detección, tareas para las que no fue entrenado expresamente.
Cifras del fabricante: la empresa dice que es el mejor modelo abierto para coding agéntico, con 41% en Terminal-Bench 4.0 (frente a 28% de la vista previa, tras tres semanas más de refuerzo) y el tope del Coding Agent Index de Artificial Analysis empatando con GLM-5.3 usando 47% menos de tokens por tarea. TechCrunch precisa que el empatado es en la prueba de ciber y que ningún benchmark independiente fue reproducido para esta nota.
Arquitectura y despliegue: el modelo combina un pool grande de expertos con atención dispersa y un codificador de visión Pixtral: el modelo de lenguaje elige un grupo pequeño de expertos por token y su índice de atención decide a qué posiciones anteriores prestar atención, dos formas distintas de sparsidad (una selecciona redes feed-forward, otra selecciona posiciones de contexto). El blog de Hugging Face lista soporte para Transformers, vLLM, llama.cpp, afinado con TRL, endpoints de inferencia y Dell Enterprise Hub, además de los GGUF de la comunidad.
La argumentación: Mistral sostiene que «ante la creciente amenaza cibernética, ML4 aporta capacidades de defensa cibernética soberana de vanguardia» y que gobiernos y empresas ahora pueden descargarlo, desplegarlo y ser dueños de la IA para detectar, analizar y responder incidentes. Pierre Stock, vicepresidente de ciencia, dijo a TechCrunch que con pesos abiertos el acceso «no puede cortarse por definición» y que el despliegue on-prem queda en manos del organismo. Es una lectura del fabricante: la licencia abierta no impide que modelos alojados por terceros presten el servicio.


