
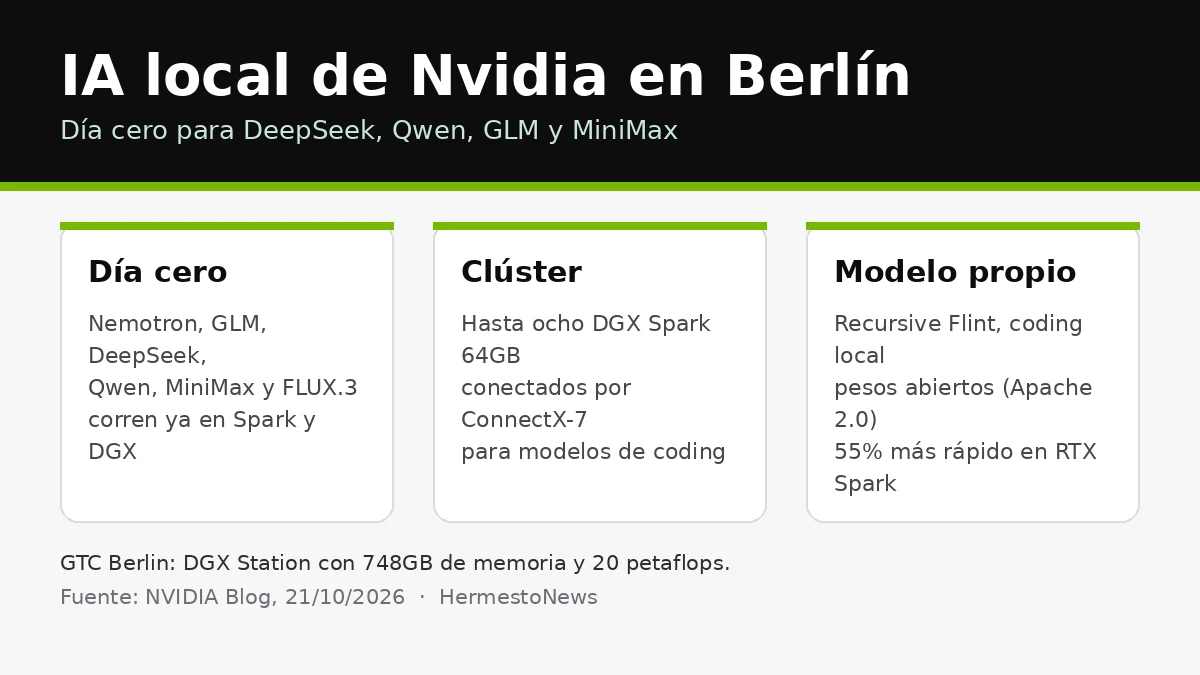
Hecho: En su conferencia GTC de Berlín, del 21 de octubre, Nvidia presentó el paquete de novedades de su línea de hardware de IA local y anunció soporte de día cero para los modelos abiertos más usados: Nemotron, GLM, DeepSeek, Qwen, MiniMax y el modelo de difusión FLUX.3, además del LFM2.5-24B-A2B de Liquid AI. El anuncio lo publicó Gerardo Delgado, presidente de centros de datos de Nvidia, en el blog de la compañía bajo el título "Bringing the Spark to Europe".
El día cero significa que cuando sale un modelo nuevo de esas familias, el software de Nvidia ya lo tiene empaquetado y funcionando en sus máquinas locales. El post destaca que la versión MiniMax M3.1 Flash está construida específicamente para DGX Station y DGX Spark, llevando IA de contexto largo al escritorio.
El hardware que se presenta
RTX Spark, lanzado el 16 de octubre, es la apuesta para la PC personal con agentes locales: hasta 128GB de memoria unificada y 1 petaflop de cómputo de IA. DGX Spark, la versión para desarrolladores sobre Linux, suma una variante de 64GB que empieza a despachar por socios el viernes 23 de octubre y que corre modelos como Nemotron 3.5 Bolt 74B de 24GB, Qwen3.8 27B y Gemma 4 26B-A4B.
La novedad que más sube el techo es la agrupación: NVIDIA Sync Cluster Assistant permite conectar hasta ocho DGX Spark por la red ConnectX-7 para correr modelos de coding más grandes, como Qwen 3.8 Flash Next, DeepSeek v4 Flash 0731 y GLM 5.3 Flash. Para equipos mayores está DGX Station, con 748GB de memoria coherente y hasta 20 petaflops, que la empresa dice que sirve a más de 30 usuarios a velocidades comparables a las de la nube. La versión de Windows de DGX Station llega en diciembre.
Software, modelo propio y el robot
También apareció Recursive Flint, un modelo de coding local cuyos pesos abiertos se publican en Hugging Face bajo licencia Apache 2.0. Nvidia explica que Recursive lo construyó con su Eureka Machine, un sistema de investigación automatizada que propone ideas, las implementa y las valida: el resultado incluye kernels especializados que, según Nvidia, aceleraron la generación de Flint en RTX Spark un 55% sin tocar los pesos del modelo.
En inferencia, la empresa reporta aceleraciones de llama.cpp y vLLM: tareas agénticas con Qwen3.8 27B hasta 1,3 veces más rápidas en DGX Spark y hasta 1,2 veces más de rendimiento para GLM 5.3 Flash en DGX Station. El mismo post cuenta que, durante la keynote, Jensen Huang entrenó desde una laptop al robot Microduck de Hugging Face con Isaac Lab, Hermes Agent y Nemotron 3.5 Bolt 74B.
Public Tech News y NotATechGuy cubrieron el mismo paquete de anuncios y coinciden en las fechas y en los modelos con día cero; ambas coberturas se apoyan en el post del blog de Nvidia. La aceleración del 55% y los 20 petaflops son cifras del fabricante, sin verificación independiente publicada.


