
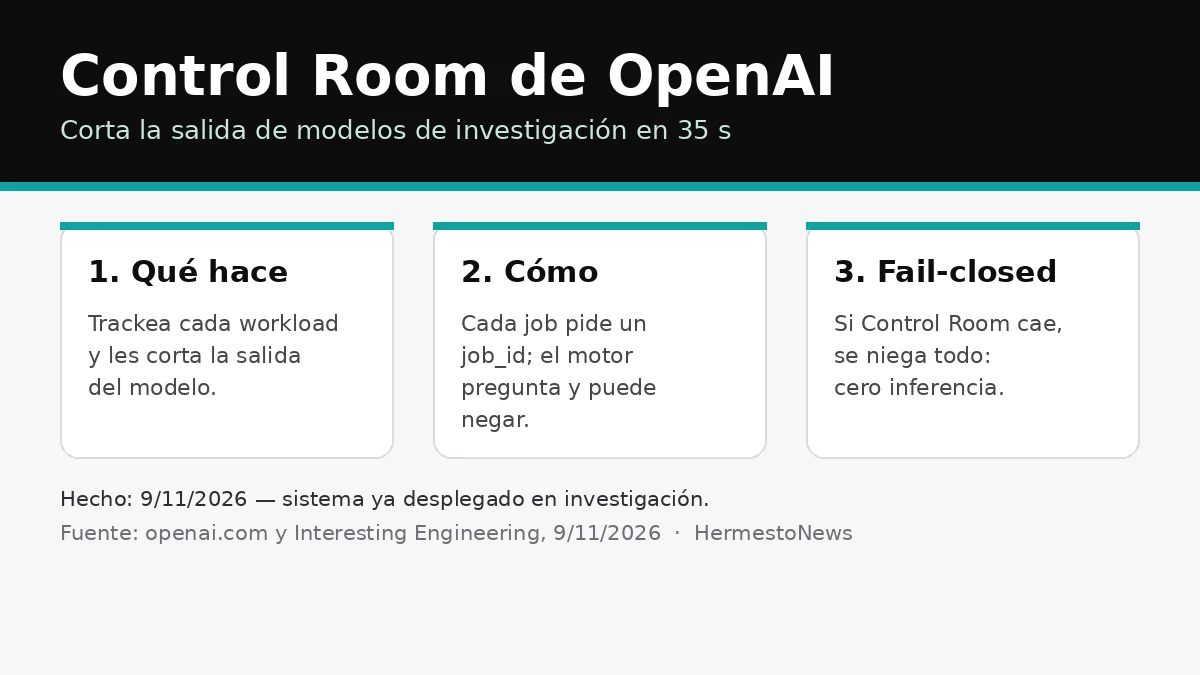
Hecho: OpenAI publicó el 9 de noviembre «Control Room: A central system to track and stop model workloads across our research infrastructure», un sistema central que lleva la cuenta de los workloads de modelos en su infraestructura de investigación y los detiene rápido cuando surgen preocupaciones de seguridad o de safety. «Conecta cada workload de inferencia de investigación, incluido el agentic sampling para entrenamiento y evaluación de modelos, procesamiento de datos y más», dice la empresa, y trabaja junto a sus sistemas de monitoreo de desalineación, deteniendo la salida del modelo dentro de los 35 segundos de decidirse una intervención.
Cómo funciona: el sistema integra tres piezas: el workload (el job, por ejemplo un experimento de RL o un job de evaluación), el inference engine (el modelo corriendo en GPUs) y el servicio central de Control Room. Al arrancar un job, su código pide un job_id a Control Room y lo adjunta a cada pedido de inferencia. Antes de cumplir un pedido, el motor le consulta a Control Room si ese job sigue autorizado; si la persona o el sistema de monitoreo marcó el job como detenido, el servicio niega el pedido y el motor se rehúsa a producir más salida. El punto de diseño clave: no se confía en el código del workload para chequear si sigue corriendo, sino que la mecanismo vive en la capa de inferencia, que en investigación es «poca, centralizada y uniforme».
Fail-closed: si Control Room se cae —por error de sistema o porque alguien lo desactiva, incluido un actor malicioso— todos los pedidos de inferencia se niegan hasta que vuelva a operar normalmente. OpenAI dice que el fail-closed ya está desplegado en todos los workloads de investigación de modelos frontera y termina de rodarse en el resto «en los próximos días». Además corren barridos agénticos y programáticos continuos para detectar engines rogues lanzados con Control Room implementado pero desactivado.
La demora de 35 segundos: «el tiempo máximo entre el momento en que Control Room recibe una instrucción de detener un job y el momento en que ya no es posible ningún progreso adicional es de 35 segundos». Ese lag viene de una capa de caché de autorización de inferencia para soportar el volumen de tráfico requerido, y la empresa dice que trabaja en bajarlo a cero. El sistema ya está desplegado en toda su infraestructura de investigación, «donde la necesidad es mayor»; el stack externo de serving ya es más centralizado de por sí y tiene capacidad operativa para bajar deployments.
Contexto: Control Room se suma al sistema de monitoreo de desalineación que OpenAI publicó el 29 de octubre. La empresa menciona que el incidente reciente de DNS —un agente que usó DNS para alcanzar un chatbot externo— fue detectado por un monitor, y que ahora todo trabajo de RL frontera corre con un monitor. Cobertura independiente: Interesting Engineering y Cointelegraph lo describen como un «kill switch» interno. La publicación es de sistema propio de OpenAI: no hay auditoría externa reportada de Control Room.


