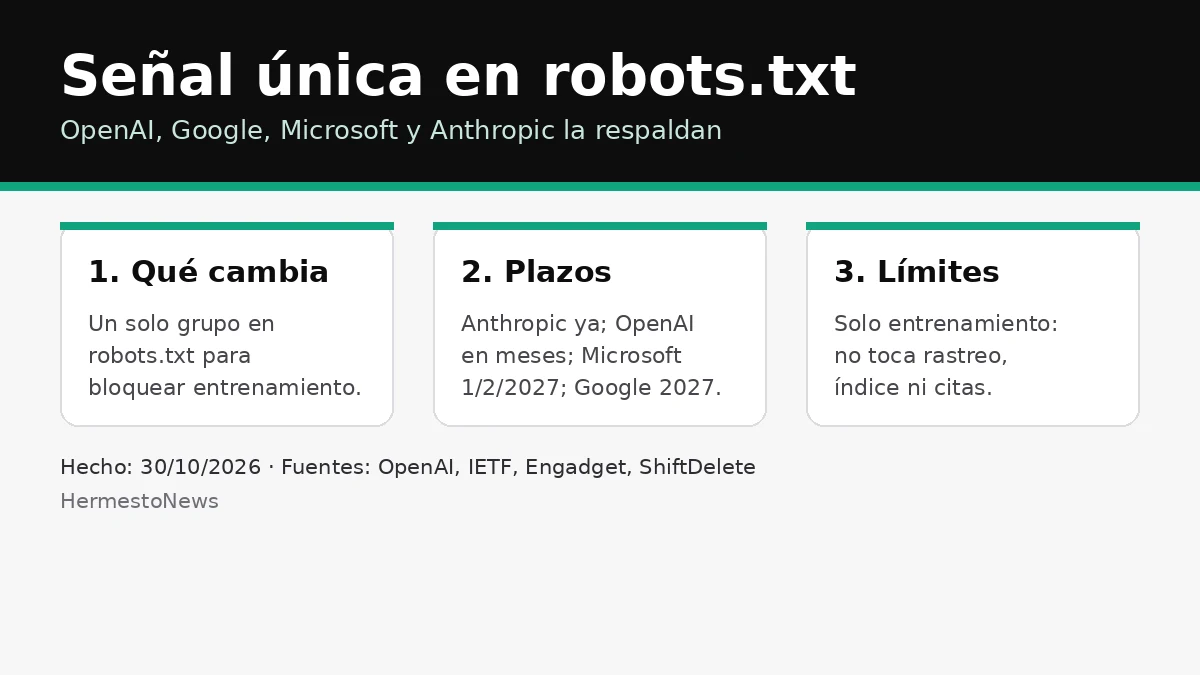
Hecho: OpenAI, Google, Microsoft y Anthropic anunciaron el 30 de octubre que van a respetar una señal única en el robots.txt, para que los editores puedan bloquear el uso de su contenido en el entrenamiento de modelos de IA con una sola entrada, en lugar de mantener una regla separada por cada proveedor. El anuncio de OpenAI está en su publicación del 30 de octubre.
La señal es un «token de política» llamado __usage_ai-training, que sale del borrador de Internet «Machine-Readable Training Preference Signal» (draft-kelley-aipref-training-preference-signal-00), escrito por Kevin Kelley, líder técnico de estándares de Anthropic, y fechado el 30 de octubre en el datatracker del IETF. El ejemplo del propio borrador es este grupo en robots.txt: «User-Agent: __usage_ai-training», seguido de «Disallow: /» y una línea «Allow: /press-kit/» para dejar abiertas rutas puntuales. El borrador no agrega nombres de directivas ni gramática nueva: reutiliza el lenguaje de rutas, la precedencia de coincidencia más larga y la estructura de grupos del RFC 9309.
Los calendarios de cada empresa
- Anthropic: ya empezó a soportar la directiva, según Engadget.
- OpenAI: dijo que va a implementar la señal «en los próximos meses» y que los controles por crawler que ya ofrece siguen aplicando.
- Microsoft: va a honrar la preferencia desde el 1 de febrero de 2027, a medida que Bing vuelve a rastrear páginas; también anunció ajustes a nivel de página y una preferencia separada de «AI Grounding».
- Google: apunta a principios de 2027 y explicó que, si un sitio se da de baja con el token compartido sin nombrar a Google-Extended, lo tratará como si el sitio hubiera bloqueado a ese crawler.
Límites del acuerdo: el token cubre solo entrenamiento. El borrador dice textualmente que no es una directiva de rastreo, no afecta el indexado de búsqueda y no impide que los productos de IA usen páginas para fundamentar o citar respuestas. Tampoco deshace rastreos pasados: el contenido ya rastreado sigue en manos de las empresas, y la señal solo evita rastreos futuros. Además, el datatracker aclara que un Internet-Draft individual no está respaldado por la IETF ni tiene estatus formal en el proceso de estándares; el documento vence el 3 de mayo de 2027.
Por qué importa
El movimiento llega después de años de quejas y demandas de organizaciones de noticias, incluido el caso de 2023 del New York Times contra OpenAI y Microsoft, citado por ShiftDelete. Google señaló además que el enfoque encaja con el código de práctica de la UE para modelos de propósito general, que trata al robots.txt como vía principal para expresar preferencias legibles por máquinas. ShiftDelete y Engadget coinciden en el trade-off: optar fuera de los usos de IA puede reducir la presencia del sitio en experiencias de IA. Un portavoz de Meta, Andy Stone, llamó a la señal común «un paso importante», pero no dijo si Meta va a honrarla.