
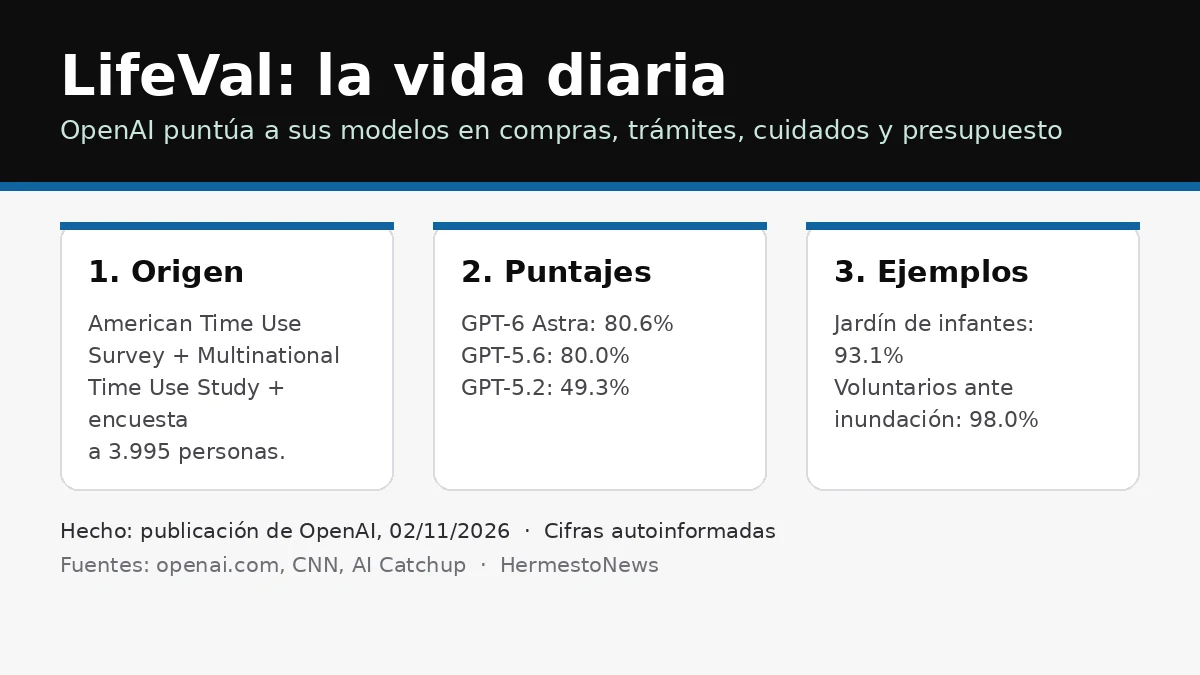
Hecho: OpenAI publicó el 2 de noviembre LifeVal, una evaluación interna de tareas cotidianas que dice haber usado durante el año pasado "para seguir y mejorar el rendimiento de los modelos en tareas de la vida diaria". Las áreas salen de la American Time Use Survey y la Multinational Time Use Study, más una encuesta propia con representatividad demográfica de 3.995 personas: cuidado de personas, salud, educación, administración del hogar, finanzas personales, compras y trámites con el Estado.
Los números (promedio de recompensa sin ponderar, todos de OpenAI): GPT-5.2 marcó 49.3%, GPT-5.4 73.0%, GPT-5.5 77.4%, GPT-5.6 80.0% y GPT-6 Astra 80.6%. En tareas individuales, los ejemplos publicados muestran 93.1% para comparar jardines de infantes y armar la lista corta después de una mudanza, 98.0% para organizar voluntarios ante una inundación, 90.4% para armar el plan de comidas de un padre con diabetes recién diagnosticada, 100% para encontrar una casa dentro del presupuesto y 96.3% para ver un partido con la abuela a distancia.
Cómo se armaron las tareas: un grupo de unos 100 usuarios escribió tareas concretas, aportó su contexto personal y definió los criterios de éxito. La investigadora Jenny Yang dijo a CNN que "había que proveer evidencia de experiencia o una comprensión sólida de qué sería la respuesta correcta para esa persona", porque el resultado depende de la situación de cada quien.
Por qué existe: LifeVal es el equivalente doméstico de GDPVal, el benchmark de OpenAI para tareas laborales. Encaja en el empuje de la empresa para convertir ChatGPT en un asistente que "haga cosas que realmente se hagan" en vez de responder en el chat: navegar sitios, buscar en el historial del usuario y llegar a conclusiones alineadas con sus necesidades.
Cómo leerla: los puntajes son autoinformados. La página de OpenAI publica solo modelos de OpenAI, sin comparación con rivales, y no incluye el set de tareas ni un leaderboard público (verificación propia sobre el texto de openai.com). CNN agrega que medir el desempeño en la vida diaria es difícil porque los pasos son amplios y vagos y los resultados son subjetivos.
Advertencia: sin benchmark externo, sin set de tareas publicado y sin modelos de otros laboratorios en la tabla, la serie mide la evolución interna de OpenAI; no es una comparación de mercado ni una prueba de confiabilidad en el mundo real.
Fuentes: OpenAI, "LifeVal", 02/11/2026 (primaria); CNN, 02/11/2026; AI Catchup, 02/11/2026; RuntimeWire, 02/11/2026.


