
La semana después del lanzamiento de Jev, el modelo de TypeSafe AI que no genera texto, se quemó la novedad del primer día y quedó a la vista lo realmente importante: los números del anuncio no sobreviven al escrutinio independiente — pero el producto sí. Pierre Addoum lo resumió mejor que nadie: los tests independientes «no dicen que sea humo, dicen que es verdad pero menos».
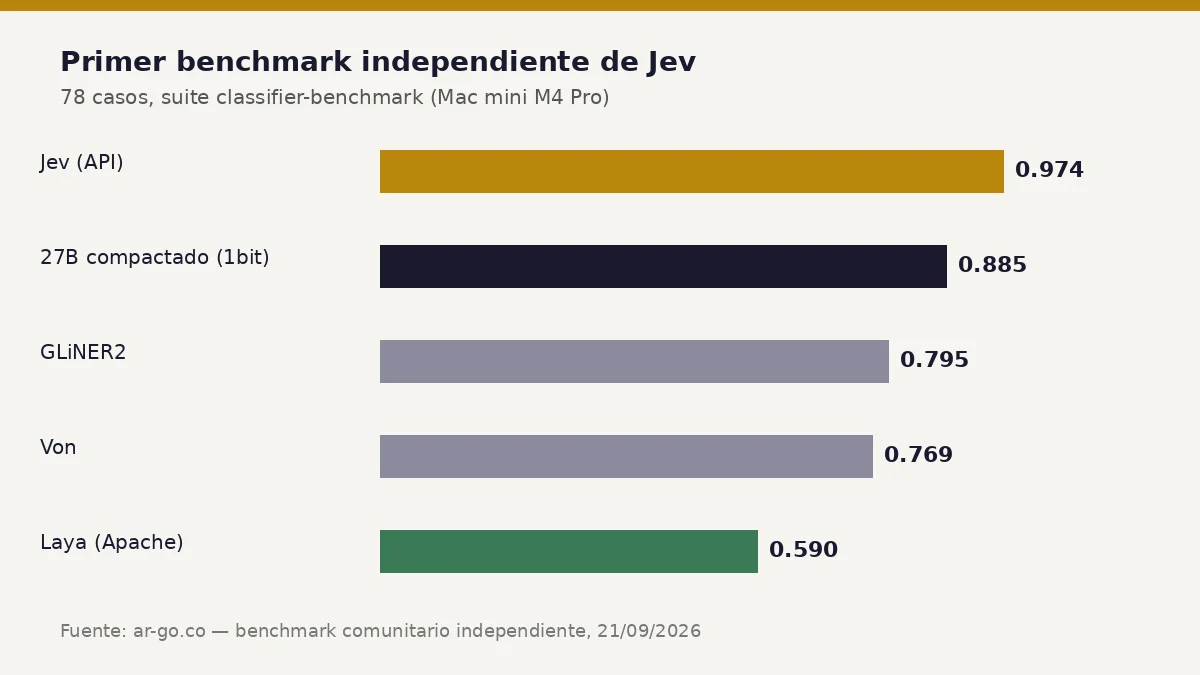
Hecho: el blog de AR-Go (Pierre Addoum, 21/09) compiló los primeros benchmarks independientes. En 78 casos del suite classifier-benchmark corriendo en un Mac mini M4 Pro, Jev tuvo el mayor puntaje de aciertos (0,974) contra un modelo 27B comprimido a un bit por peso (0,885), GLiNER2 y Von. Pero Laya, el motor de decisiones open source de Apache-2.0, siguió siendo el más rápido: 30 ms por caso contra unos 302 ms de Jev. La velocidad prometida está aceptada; la ventaja de inteligencia no, y el precio del suelo de esta capa ya tiende a cero.
Hecho: los números multiplicadores del propio TypeSafe —193,6 veces más rápido y 444,6 veces más barato— salen del extremo superior de cuatro flujos de trabajo diseñados por su equipo. La referencia de "respuesta correcta" es el promedio de los juicios de dos modelos rivales: GPT-6 Astra y Claude Fable 5.1. Con eso se mide el parecido con esos modelos, no la corrección. En los mismos 711 casos, Jev agrega 67,8% de acuerdo contra 74,1% del mejor comparador, y en facturación la brecha se ensancha: 61,8% contra 79,1%. Gana las columnas de costo y latencia, pierde en precisión.
Hecho: la comparación de velocidad y costo fue medida con los rivales en su configuración por defecto, sin razonamiento extendido, mientras que el objetivo de precisión viene de esos mismos modelos con razonamiento al máximo. Un modelo puede estar en 0% de "alucinación" y aun así marcar «spam» mal en dos de cada diez casos — el propio Almeida lo admitió en Hacker News: Jev puede ser schema-valid pero factualmente incorrecto. El eslogan «zero hallucinations» es una garantía del tipo de salida, no una propiedad empírica de acierto.
Hecho: la adopción sí es de terceros y notable: Vercel la reportó como el modelo de adopción más rápida en la historia de su AI Gateway, con cerca del 13% de sus equipos pagos conectados dentro de las primeras 24 horas, unas seis veces la cuota de día uno de Fable 5.1. En tres días Cloudflare, LangChain y Langfuse ya tenían integraciones (la entrevista de Almeida en Latent Space repasa el devenir y los riesgos): LangChain sumó el 21/09 a Jev como juez automatizado dentro de LangSmith Evals, y el directorio comunitario Jevable ya listaba 194 proyectos relacionados.
Hecho: la arquitectura de investigación no es pública, el método de entrenamiento RLCD tampoco se puede reproducir, y la empresa no ha revelado ingresos ni clientes de producción con nombre. El precio de 0,042 dólares por millón de tokens de entrada puede estar subsidiado por la ronda semilla de 40 millones de dólares liderada por DCVC: la propia TypeSafe dice que no puede demostrar lo contrario.
Opinión: hay dos niveles de lectura en medio de la euforia. El técnico: el trade-off que ofrece Jev (algo de precisión a cambio de una caída brutal de costo y latencia) es un excelente trato para tareas de bajo riesgo y alto volumen — clasificar, priorizar, enrutar — y un error de compra para las de alto riesgo, donde ese 61,8% de acuerdo en facturación no es aceptable. El comercial: ninguna de las cifras mágicas del lanzamiento debería leerse sin su origen «evals del propio fabricante». Lo sano es tomar la velocidad, ser escéptico con la precisión, y esperar el benchmark que aún nadie ha hecho: cuidado con la innovación que publica solo sus propios números.


