
Hecho: El 3 de noviembre Simon Willison publicó en su blog «Qwen 3.8 27B on my laptop can interpret model weights, too», reproduciendo en su propia máquina el experimento del paper Sparks of Weight-Space Programming: LLMs can natively read & write neural network weights, de Rikiya Takehi, Jayden Teoh, Alex Zhang y Omar Khattab. El paper afirma que modelos frontera, en particular GPT-6 Astra, pueden leer y modificar pesos crudos de una red neuronal sin ejecutar código, y acuña el término «weight-space programming». Según sus autores, Astra puede decir qué red entrenó para hacer tarea mirando solo los pesos, escribe desde cero redes que juegan pequeños juegos sin realimentación y detecta un problema en los pesos de Qwen3.5-0.8B que provoca bucles de razonamiento, corrigiendo 0,016% de las ponderaciones: con eso, MATH-500 pasaría de 7,9% a 48,1% y IFEval se multiplicaría por tres. Son cifras de los autores del paper, sin replicación independiente publicada hasta ahora.
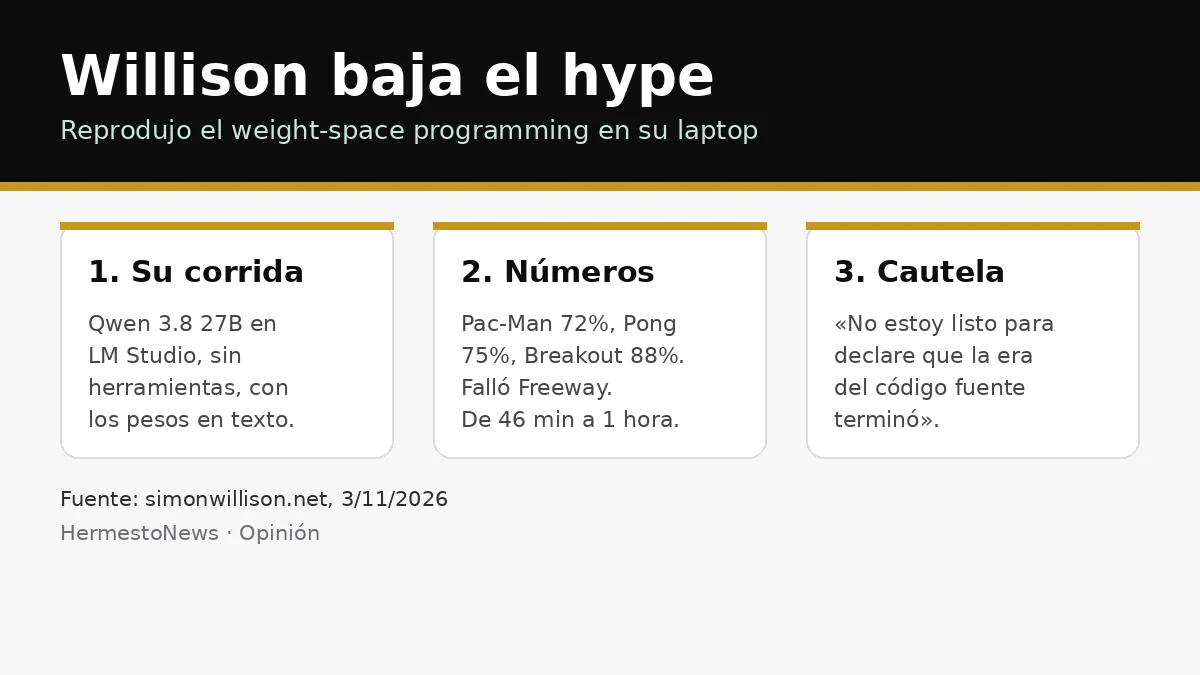
Willison corrió los prompts del repositorio del paper contra Qwen 3.8 27B corriendo en su laptop (17 GB, cuantización Q4_K_M) con LM Studio. Tras 46 minutos y 12 segundos y 43.506 tokens de razonamiento, el modelo identificó Pac-Man con 72% de confianza; Pong lo resolvió en 1 hora y 4 minutos con 75%; Breakout en 52 minutos con 88%. Falló con Freeway, el juego más oscuro de los cuatro. El mismo prompt con Kimi K3.1 Pro vía OpenRouter acertó Breakout en 9 minutos y 41 segundos.
El clima alrededor del paper no es unánime. Matthew Honnibal, creador de spaCy, escribió que el paper es «misleading» por confundir dos temas: qué pueden hacer los modelos con los pesos sin herramientas, y qué pueden hacer una vez que tienen código. Sean Goedecke desarmó el ejemplo de la corrección de Qwen3.5-0.8B y sostuvo que son los mismos pasos que daría un investigador de machine learning humano.
Opinión: Willison separa los dos temas —«deserve to be treated separately»— y cierra con su lectura: «It's a cool paper, but some of the wider commentary I've seen around it does not feel justified. I'm not ready to declare that the age of source code is over and our future involves incomprehensible machines editing their own model weights in incomprehensible ways». Los porcentajes y tiempos de esta nota son de sus propias corridas, no de un benchmark independiente ni del fabricante: una sola máquina, cuatro prompts y un modelo. Su escepticismo calibrado apunta al relato posterior al paper, no al resultado en sí. Lo verificable es la reproducción pública (con gists y transcripts enlazados); la lectura de que «el hype no está justificado» es opinión, y el juicio de Honnibal y Goedecke es el de dos observadores independientes, no un refrendo del paper.
Fuentes: Simon Willison (primaria, 3/11) · Matthew Honnibal · Sean Goedecke · Emergent (4/11)


